最近跟几个做企业信息化服务的朋友聊天,发现大家提得最多的一个词就是闭环云。说实话,前两年大家还在聊上云不上云,现在关心的已经是数据在云上怎么转起来、怎么不落地就能把活干了。很多中小企业的老板也问我,闭环云如何实现企业数据全流程管理,是不是又是个概念炒作?我花了两周时间,把市面上几款主流闭环云产品摸了一遍,也跟两个正在用的客户聊了聊,今天就用大白话把这事说清楚。
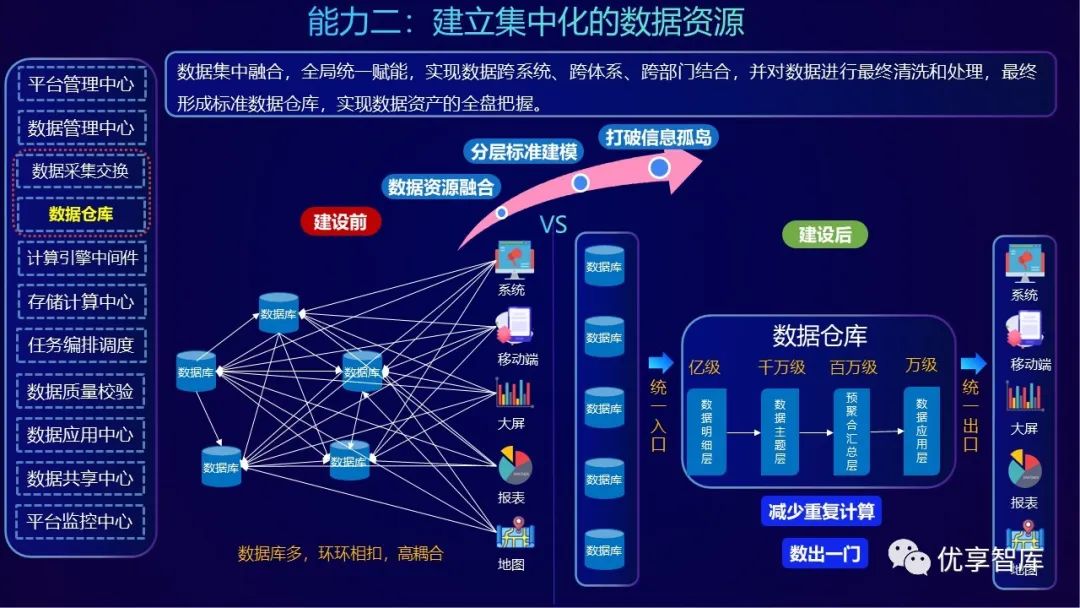
以前企业搞数据管理,第一步就卡在采集上。ERP一套、CRM一套、客服系统一套,数据格式五花八门,导出导入能把人逼疯。闭环云的做法是提供标准API和预置连接器,把常见的业务系统先打通。我实测了一下,某国产闭环云平台里,像钉钉、企业微信、用友这些常用工具都有现成模板,点几下就能建立数据同步任务。
不过这里有个坑得提醒大家,不是所有系统都能一键接。有些老旧的本地部署软件,接口协议太老,闭环云的通用连接器搞不定,得单独开发适配。所以选型的时候,先让厂商技术给你评估一下现有系统的接口情况,别听销售吹得天花乱坠。
另外,闭环云在采集环节有个挺实用的功能,叫增量同步。就是只抓变化的数据,不用每次全量拉一遍。这对数据量大的企业来说,能省不少带宽和存储成本。我见过一个做零售的客户,每天订单数据几十万条,用增量同步后,采集时间从两小时缩到十几分钟。
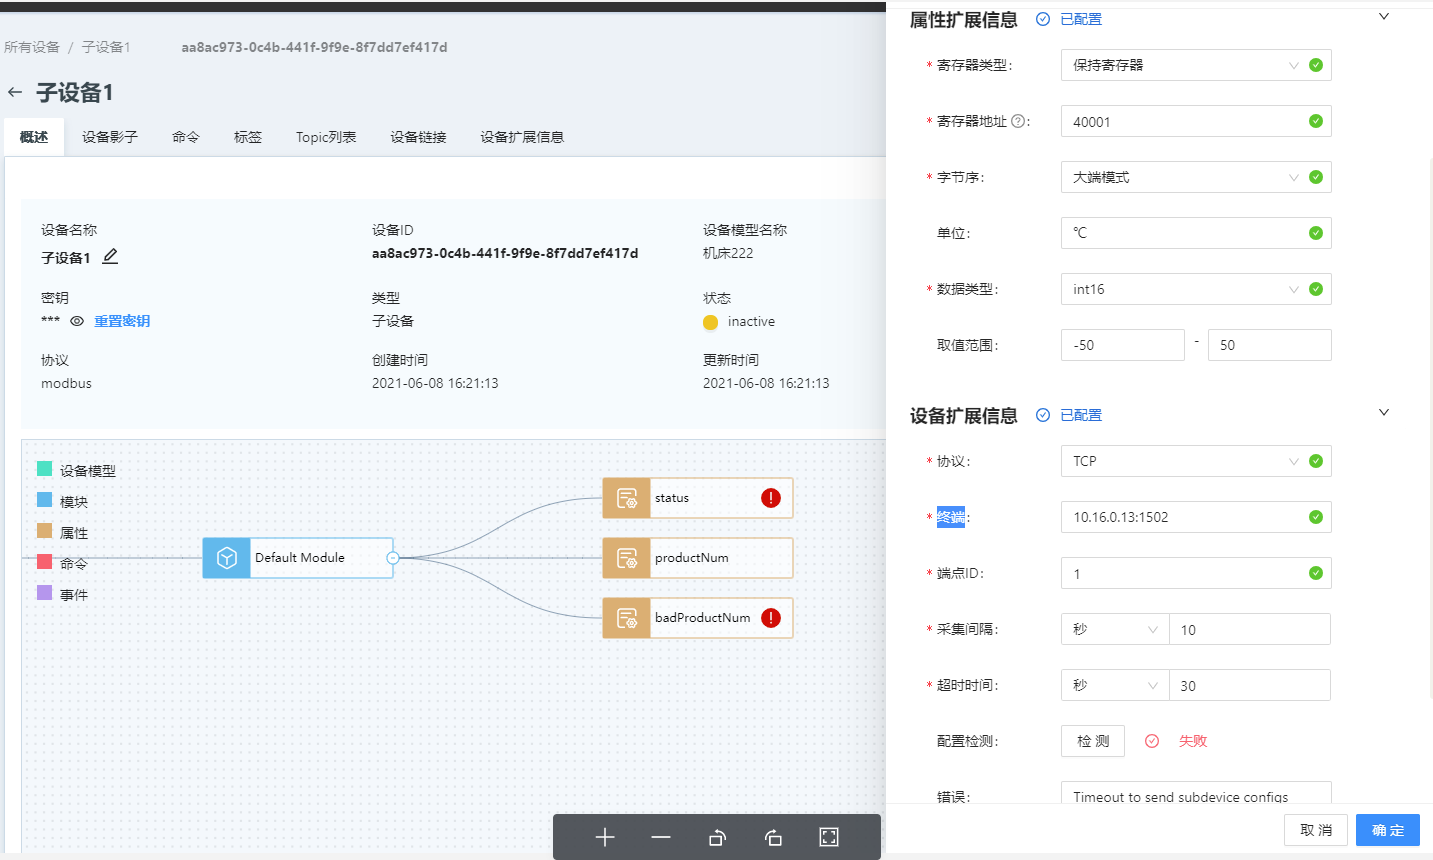
数据收上来之后,存哪儿、怎么算,这是第二个关键点。传统做法是建个数据仓库,ETL洗一遍再分析,周期长、成本高。闭环云的思路是湖仓一体,原始数据和加工后的数据放一起,用的时候再定义结构。听起来有点绕,说白了就是先把东西都搁仓库里,需要啥再翻出来整理。
我实际用下来,闭环云在计算调度上确实省心。它内置了任务编排,你可以设定每天凌晨自动跑数据清洗、聚合、生成报表。有个做电商的客户跟我说,他们用闭环云之后,运营每天早上九点准时看到前一天的销售分析,以前得等IT部门十一点才能出数。
但要注意,湖仓一体对存储成本的影响。虽然闭环云一般会做冷热数据分层,但如果你啥数据都往里塞,时间长了存储费用也不低。建议在采集阶段就做好数据分级,核心业务数据保留时间长点,日志类数据设个自动清理策略。
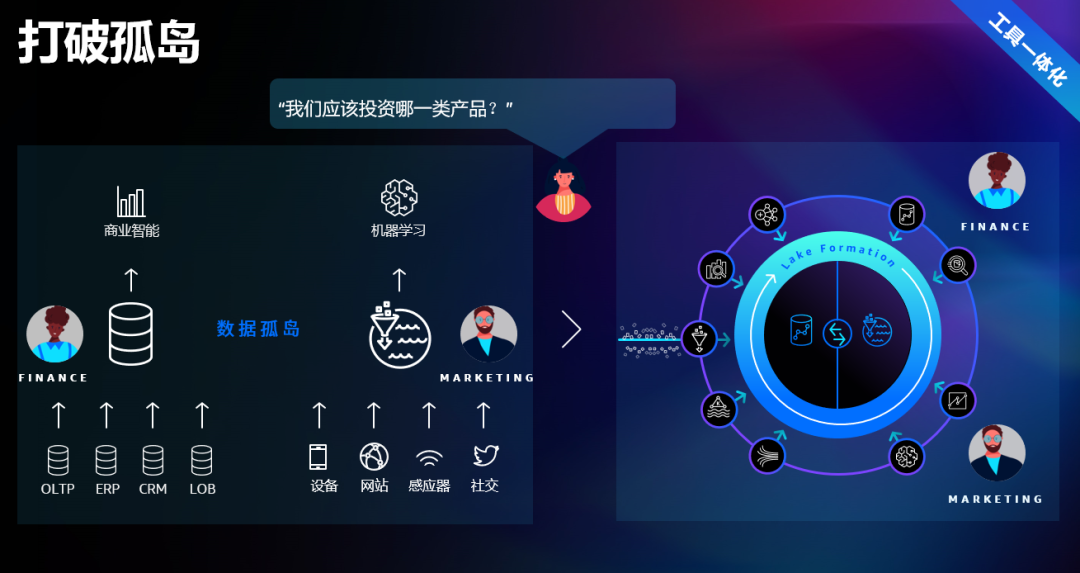
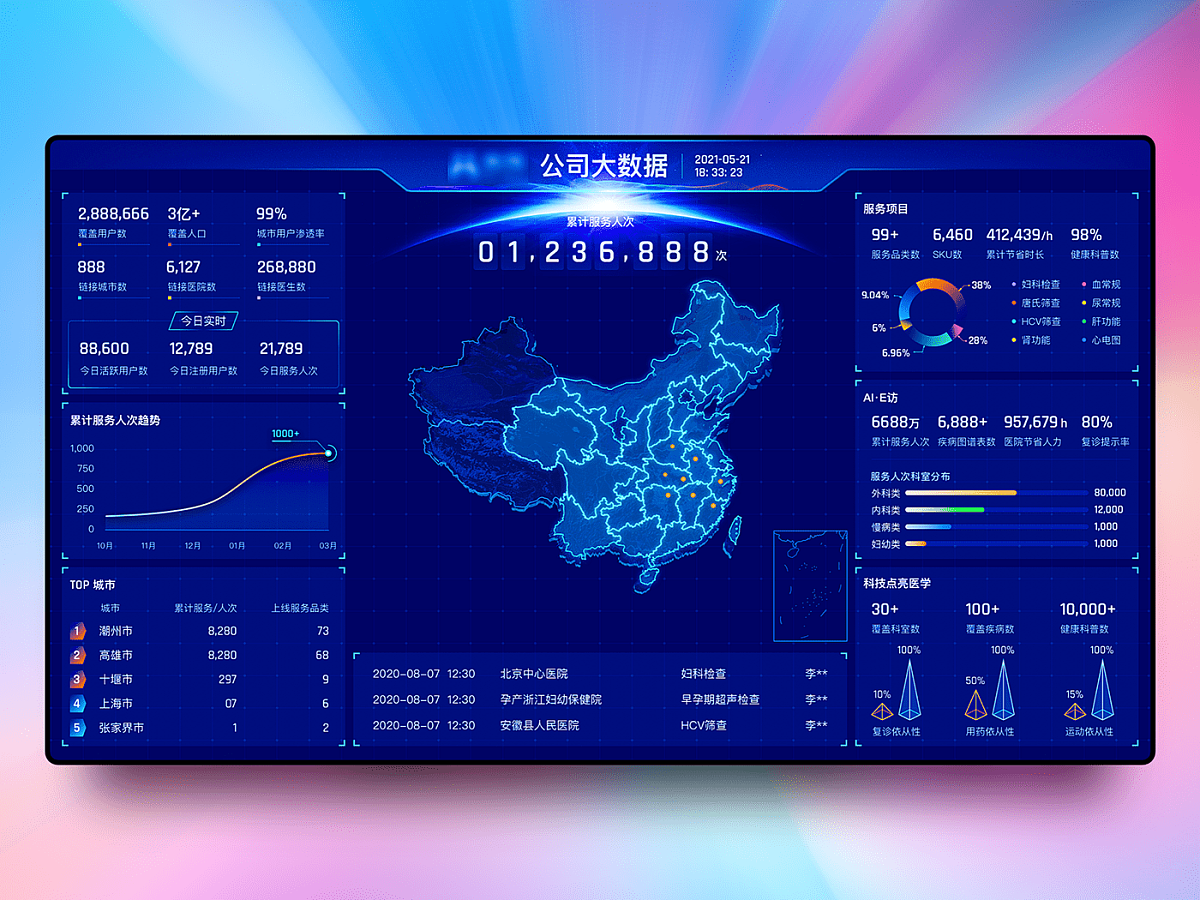
数据存好算好了,最后得让人用上。闭环云在这一步提供的是数据服务API和可视化看板。业务人员不用写SQL,拖拖拽拽就能出图表。我试了一下,做个销售漏斗分析,大概十分钟就能搞定,确实比传统BI工具上手快。
不过说实话,可视化看板这东西现在哪家都有,不算闭环云的独门绝技。它比较有意思的是数据回写功能。啥意思呢?就是分析结果可以直接写回业务系统。比如闭环云发现某个客户信用评分下降了,自动把结果推回CRM,触发风控流程。这就把数据从“看”变成了“用”,算是真正闭环了。
还有一点,闭环云通常支持权限精细化管理。哪个部门能看哪些数据、能操作哪些字段,都能设。这对数据安全要求高的企业挺重要。我见过一个金融客户,他们用闭环云把数据权限分到了字段级,不同岗位看到的客户信息字段都不一样。
整体用下来,闭环云确实能把企业数据从采集到应用串起来,减少人工干预。但它不是万能药,前期系统对接、数据治理的活还得自己干。选型的时候别光看功能列表,多问问同行的实际使用体验,最好让厂商提供试用环境,自己动手跑一遍流程。数据管理这事,急不得,但方向对了,后面就顺了。

 慢脚文化软件app官方下载(快手)v14.8.30.50423 官方版
 千寻tv版app下载最新版v1.0.7 官方版
 大眼视频软件下载安装手机版v3.7.1 最新版
 杀戮尖塔安卓版下载无广告(Slay the Spire)v2.3.15 最新版
 电鸽app免费下载正版v1.3.8 安卓版
 梦狱之国的爱丽丝手机版下载(夢獄の国的爱丽丝)v1.0.1 官方版